
不少企業的 AI 項目,剛開始只是一個問答框,后來接上知識庫、文件、工具和業務日志。功能越來越多,響應卻越來越慢,賬單也越來越難解釋。團隊第一反應往往是換更大的模型,或者繼續加服務器,但真正膨脹的可能是每次請求帶進去的上下文。
這篇文章不把模型大小當作唯一答案,而是給出一個更穩妥的順序:先用一份脫敏樣本,把輸入規模、結果完整性、運行表現和回退路徑查清楚,再決定是否擴容。
本文依據 Headroom 官方倉庫與 README、官方 pyproject.toml、Apache-2.0 LICENSE 和 v0.37.0 Release 整理。我們沒有在本機安裝 Headroom、啟動 Proxy、連接真實模型或復現官方 README 的壓縮比例;命令和效果數字均按官方說明或項目自報標注。
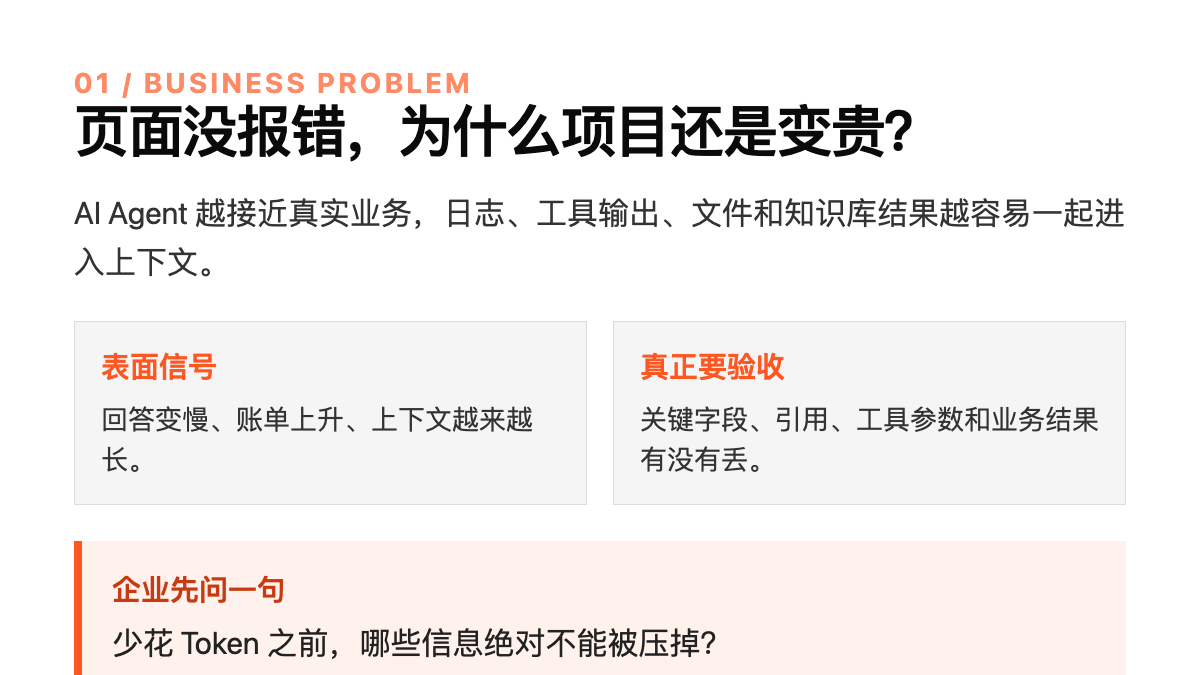
先分清:省 Token,不等于業務更好
Headroom 是一個開源的上下文壓縮層。官方 README 描述了代碼庫調用、Proxy、Agent wrap 和 MCP 等接入方式,可以處理工具輸出、日志、文件、RAG 片段和會話歷史,并提供原文取回路徑。
企業應把問題拆成兩層:成本層看輸入規模、延遲、超時和重試;業務層看關鍵字段、引用、工具參數和最終業務結果是否完整。如果只看 Token 數字,不看答案和業務記錄,優化可能只是把賬單問題換成返工問題。
官方最短路徑:先把工具跑起來
官方項目元數據要求 Python 3.10 或更高版本,當前倉庫版本為 0.37.0。README 給出的基礎路徑是:
uv tool install --python 3.13 "headroom-ai[all]"
headroom deploy
headroom doctor
headroom perf
如果目標是少改現有代碼,官方還給出:
headroom proxy --port 8787npm 上的 headroom-ai 是 TypeScript SDK,不提供 headroom CLI。可選 extras 也有額外的 Python、編譯工具、模型或平臺要求,不能把一條安裝命令當成所有機器都能直接生產運行。
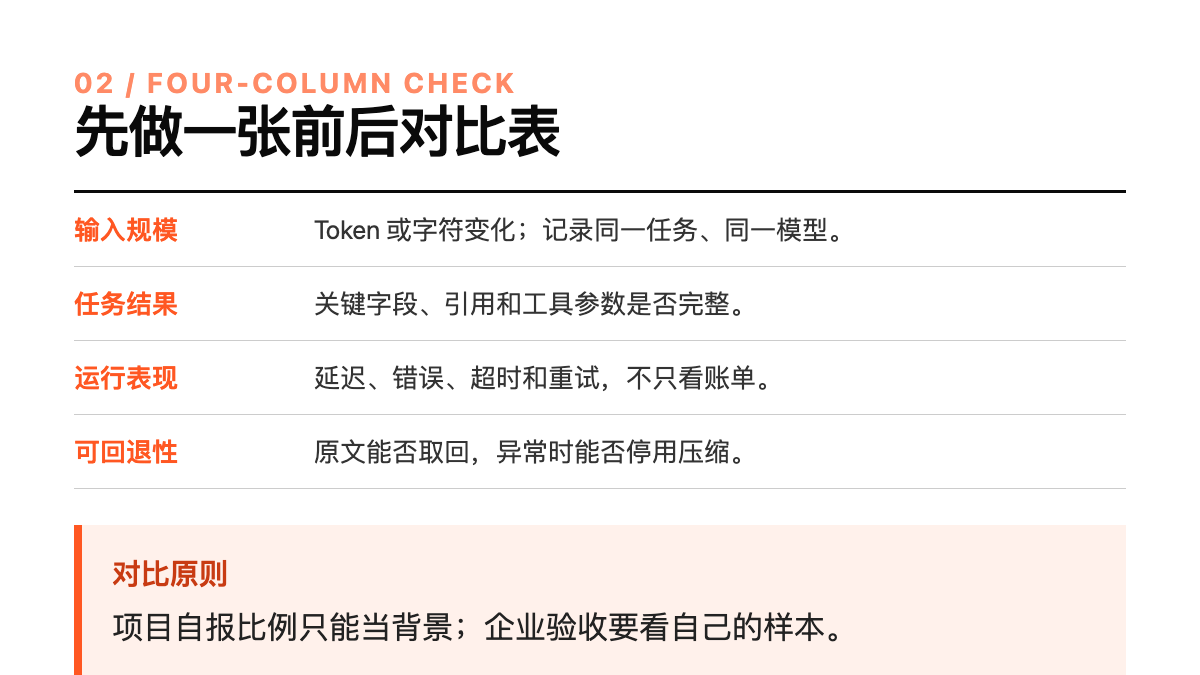
企業體檢,先固定四列
選一個固定任務、一個固定模型和一份已經脫敏的樣本,做未壓縮與壓縮后的雙跑。建議記錄:
- 輸入規模:Token 或字符變化;
- 任務結果:必填字段、引用、工具參數和結構化輸出;
- 運行表現:延遲、錯誤、超時和重試;
- 可回退性:原文能否取回,異常時能否停用壓縮。
Headroom README 給出了若干場景的項目自報對比。這些內容可以幫助理解方向,但不能直接當成企業自己的節省比例,更不能寫成賬單下降保證。
接入順序:先樣品,再 Proxy 或 MCP
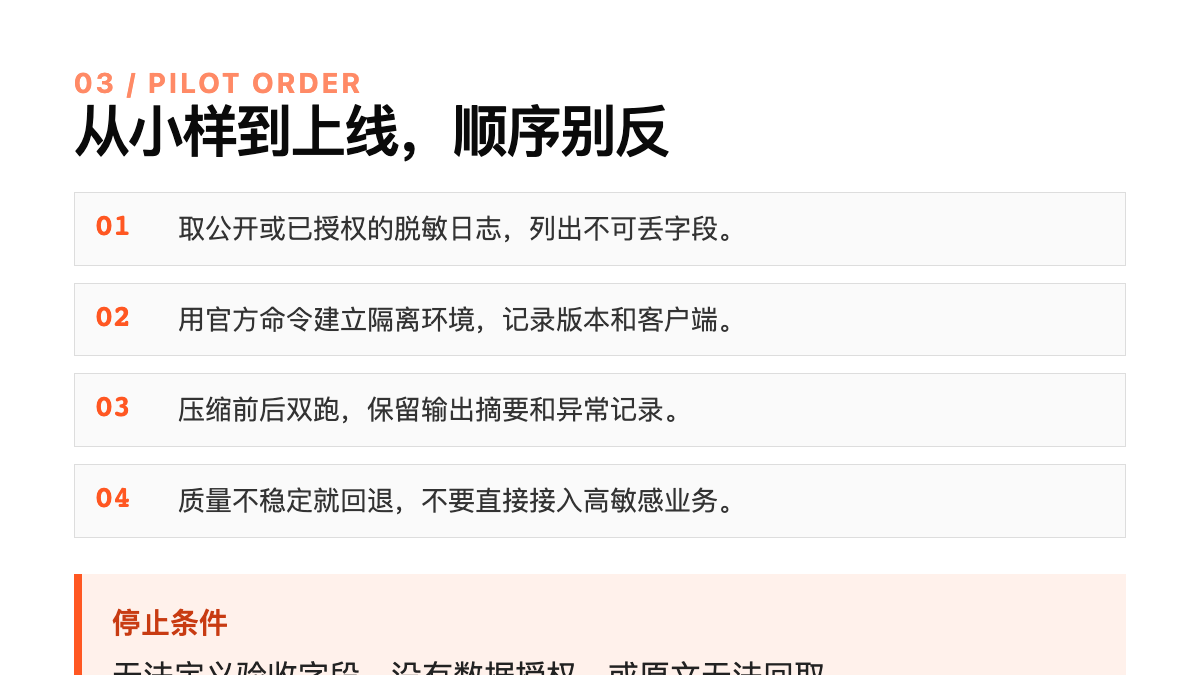
第一輪不要直接改生產 Agent 的全局配置,也不要在客戶真實數據上試。更穩妥的順序是:取公開數據或已授權的脫敏日志,圈出絕對不能丟的字段;在隔離環境登記 Python、Headroom 版本、模型和客戶端;先做 doctor 或 perf,再對同一任務做前后雙跑;質量穩定后,再選擇 Library、Proxy 或 MCP 其中一種接入。
官方說明中,Agent wrap 可能涉及用戶范圍的配置和本地服務。配置變化要可記錄、可撤回;“本地運行”也不等于目標系統、模型供應商和日志天然都在企業控制范圍內。
七天驗證,不是七天上線
第一天確定低風險任務、固定模型和不可丟字段;第二天整理脫敏樣本,登記權限、留存和刪除規則;第三天按官方路徑安裝,留下版本與環境記錄;第四天做壓縮前后雙跑;第五天加入超長 JSON、重復日志或不穩定工具輸出,觀察是否安全停止;第六天讓三位可能買方看一頁報告,只問是否愿意提供脫敏樣本;第七天根據質量、維護成本和授權情況,決定繼續、縮小或停止。
可能的買方包括內部 IT 負責人、數字化負責人和本地技術服務商。樣本盤點、配置、回歸驗收和持續巡檢可以成為服務項;當前沒有價格、客戶、訂單、節省金額或收入證據。
四條停止線
關鍵字段或引用丟失、壓縮后工具參數改變、原文無法取回或異常無法回退、樣本沒有明確授權或沒人負責最終核對,這四類情況都不應直接擴容。企業應先保留現場、暫停變更、回到未壓縮路徑,再由業務負責人和 IT 共同判斷。
適用邊界和服務入口
Headroom 適合用來做上下文治理和驗證底座,尤其適合已經有 AI Agent、知識庫或工具調用、但無法解釋輸入為什么膨脹的團隊。它不等于模型質量保險,也不等于所有客戶端、模型和日志都能直接兼容。
上海煜企智能科技有限公司可以協助上海及周邊企業盤點 AI 流程樣本、搭建隔離驗證、配置回歸檢查和交接文件。具體系統、數據權限、第三方模型條款和服務范圍,需要企業審批、官方文檔與目標環境測試共同確認。